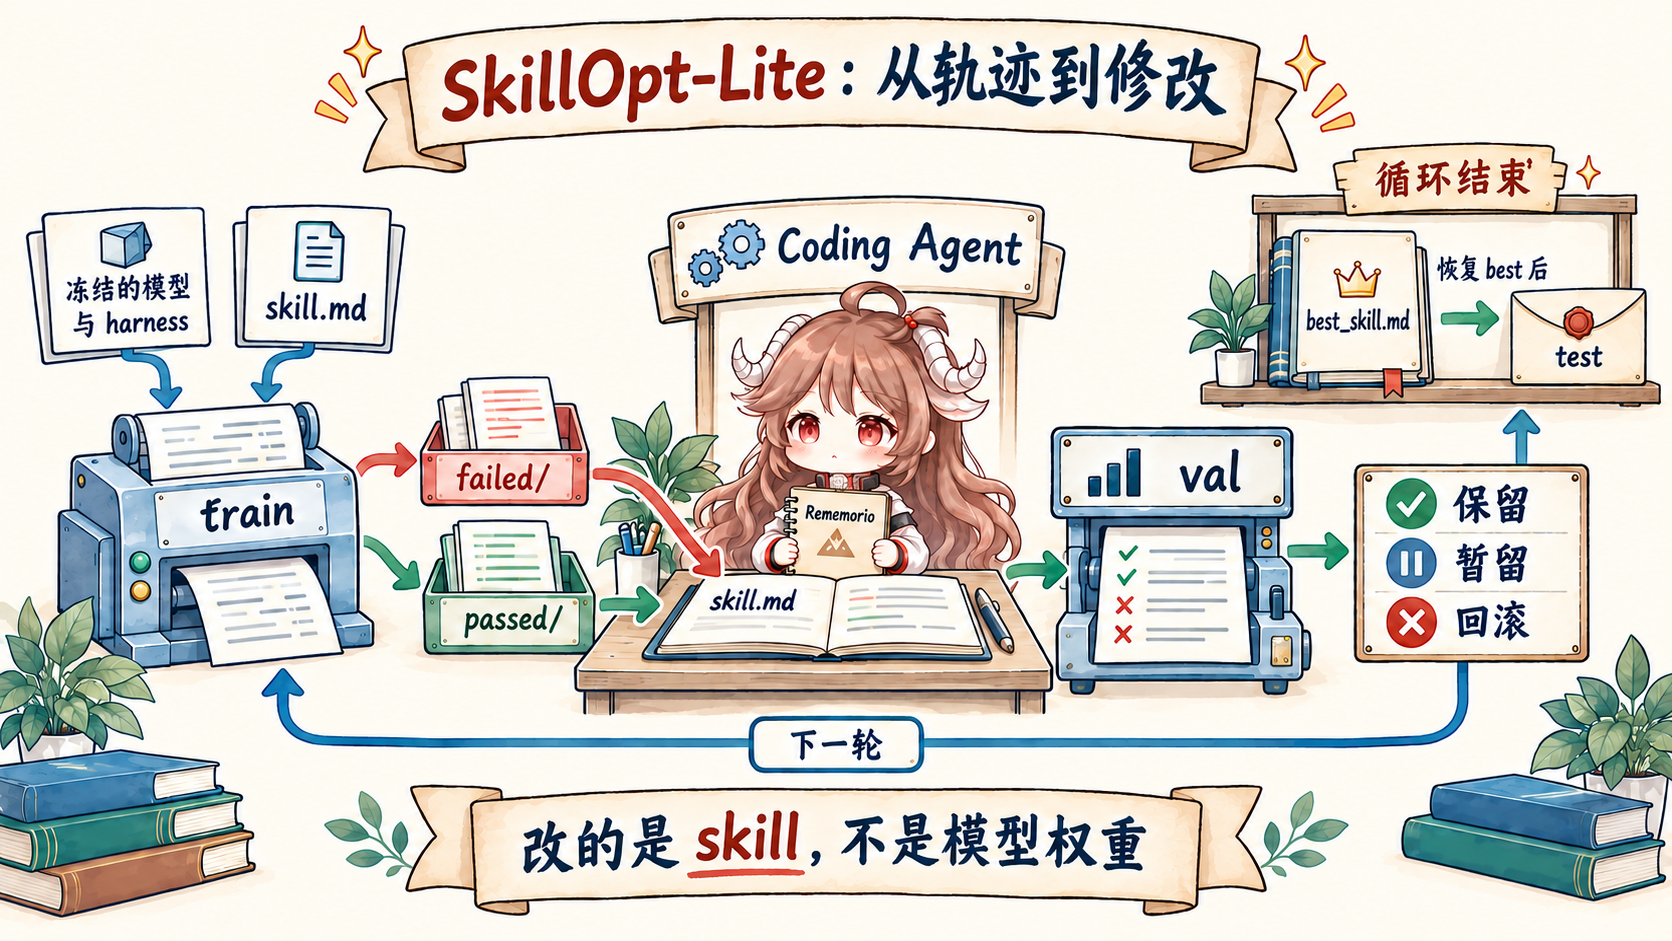
SkillOpt-Lite / HarnessOpt
从轨迹文件修改 skill 或 harness
Lite 让 Coding Agent 阅读轨迹并改写 skill.md;HarnessOpt 则在另一条路径中允许修改列明的 agent Python 文件。
需要核实:验证与回退依赖提示词执行纪律;公开复现路径的断点已在第一篇逐项说明。
Agent 自进化
从 SkillOpt-Lite 出发,比较 SkillOpt、GEPA、TextGrad 与 EvoAgentX 改变什么、怎样获得反馈,以及谁决定保留修改。
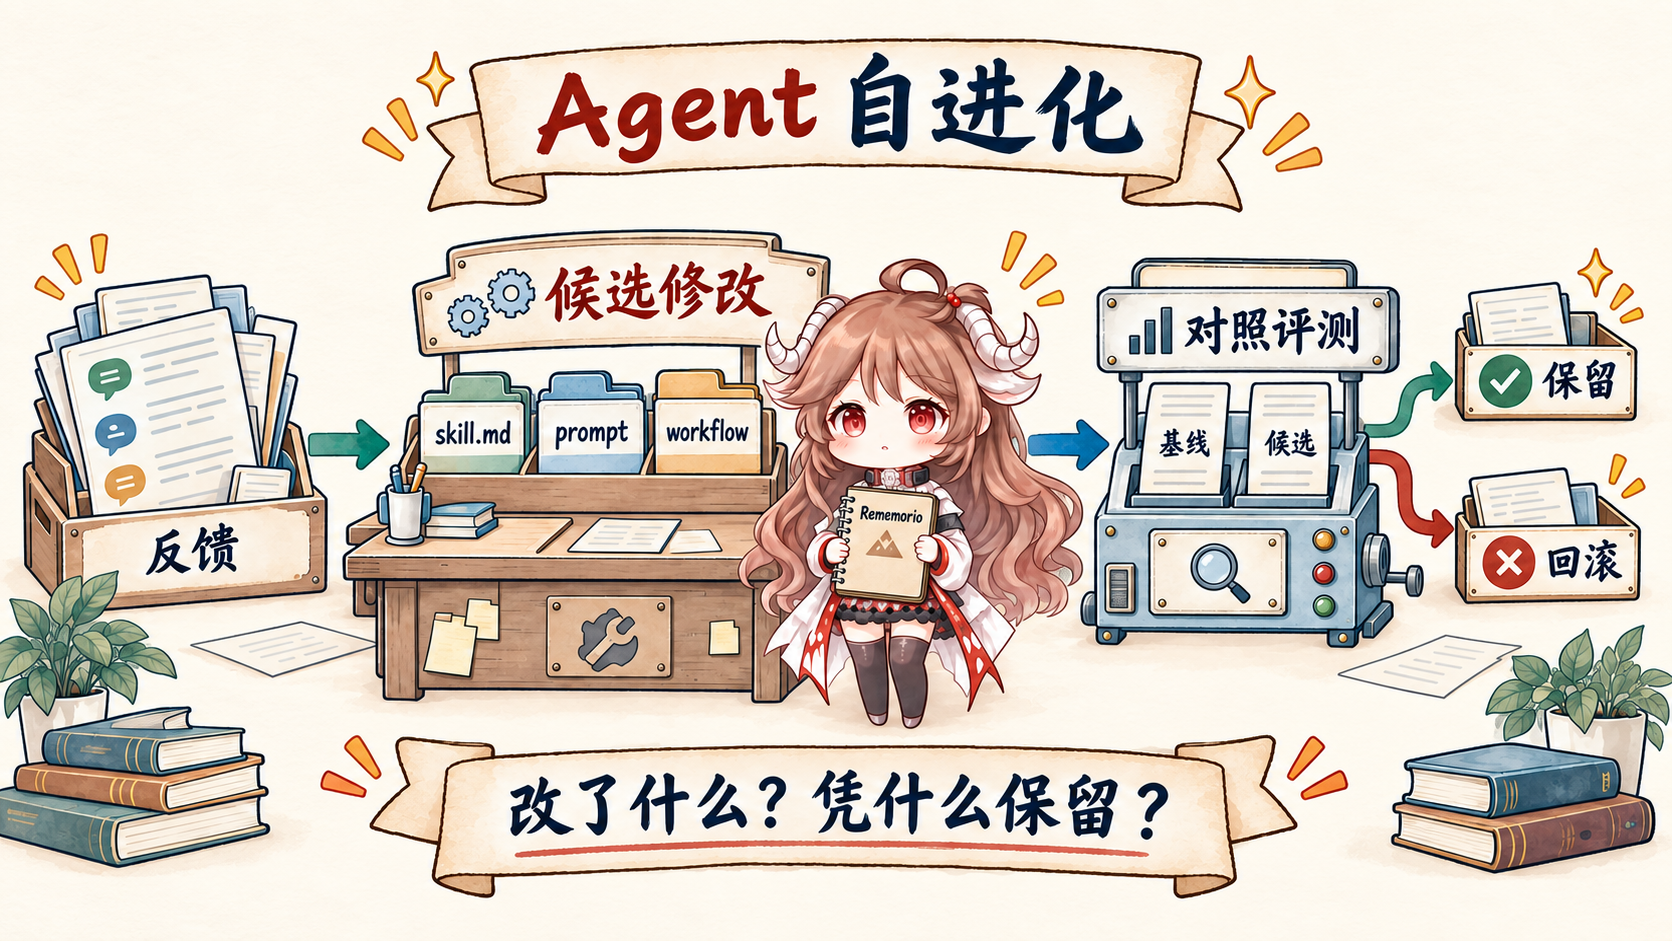
阅读主线。先跟着 SkillOpt-Lite 看一轮可以重跑的修改,再比较更完整的 skill 优化、文字反馈传播和工作流搜索。评分提高、独立测试通过与实际部署,是三个不同判断。
已发布篇章
第一篇建立共同问题:谁触发修改、能改哪些文件、用什么数据验证、怎样保留或回退。
开源项目阅读线索
这些项目覆盖不同的可修改对象与反馈方式。下面链接直接通往官方仓库和资料,不代表本站已经发表了对应源码篇章。
微软的 SkillOpt 与 SkillOpt-Lite 是两个仓库。Lite 的官方说明明确表示它基于 SkillOpt,把优化循环交给 Coding Agent;HarnessOpt 则在 Lite 同仓库中扩展到 agent 代码。Lite 内附的 Full trainer 与微软仓库当前版本不能当作同一份实现。
从轨迹文件修改 skill 或 harness
Lite 让 Coding Agent 阅读轨迹并改写 skill.md;HarnessOpt 则在另一条路径中允许修改列明的 agent Python 文件。
需要核实:验证与回退依赖提示词执行纪律;公开复现路径的断点已在第一篇逐项说明。
把自然语言 skill 当作优化对象
在模型外部维护 skill,用评分轨迹驱动反思、汇总、候选选择和有预算的修改,再由验证分数决定是否接受。
需要核实:反复用于候选选择的验证集不等于最终独立测试;不同扩展模式的接受规则仍需分别检查。
用执行反馈搜索互有长处的候选
让模型读取执行轨迹并提出文本修改,再通过评分与 Pareto 候选选择,保留在不同任务上表现突出的版本。可改范围由 adapter 与候选定义决定。
需要核实:valset 未提供时会复用 trainset;独立验证需要调用者明确提供。
沿计算图传播文字反馈
把语言模型给出的文字反馈传回提示词、答案或代码等文本变量,由优化器据此改写变量。这里的“梯度”是文字反馈。
需要核实:optimizer.step() 会直接替换变量;官方 prompt 示例中的验证回退由可选开关启用,并非优化器天然保证。
把优化范围扩展到多 Agent 工作流
框架提供多种优化器;以 SEW 为例,在开发集上评估 prompt 或工作流结构的修改,记录快照并选择评分更高的工作流。
需要核实:不同优化器的规则不同;调用者需要正确提供开发集与测试集,不能把 SEW 的行为概括成全框架承诺。