先接着 Mem0 的问题往下走。外置 memory layer 的好处是应用可以把对话交给一层服务, 让它抽取、去重、排序,再把少量结果放回模型上下文。Letta 换了一个切入点: 长期工作的 agent 需要恢复的是一个运行对象,里面有偏好、人格、工具能力、当前消息窗口和文件视图。 这些内容如果只在回答前临时检索,Agent 每次都像刚刚被拼装出来。
读完后你应该能回答。
读完这一篇,应该能回答三件事:Letta 的 memory_blocks 和 Mem0 的 memory records 有什么不同;
为什么 Block 更新会影响 system prompt;Letta Code 的 MemFS 为什么更像“agent 的可版本化上下文”,而不只是文件同步。
为了避免把 Block 读成“检索命中的文本片段”,这一篇只追踪一条代表性内容:
human block 里写着“用户希望回答短一点”。它从创建 agent 时进入状态,回答时被编译进 system prompt,
更新时可能触发 prompt rebuild,恢复 agent 时又跟 message window、tools 和 identity 一起回来。
核心过程很直接:Letta 持久化 AgentState,构造模型请求时再由 Memory.compile() 选择并渲染 Block。
| 阶段 | 触发者 | 持久化位置 | 下一轮模型输入的变化 |
|---|---|---|---|
| 创建 agent | 创建请求里的 memory_blocks |
AgentState.blocks |
偏好随 Agent 初始化,后续请求可直接编译进 prompt。 |
| 保存快照 | 运行时持久化 agent state | AgentState.blocks |
记忆和 model、tools、message ids 一起恢复。 |
| 进入模型 | 构造 LLM 请求 | Memory.compile() 读取 blocks |
block 被编译成这一轮 system prompt 的一部分。 |
| 后续更新 | 用户、工具或接口修改 block | AgentState.blocks;Letta Code 还会映射到 MemFS 文件上下文 |
下一轮重新 compile 时,第一条 system message 可能变化。 |
本文依据与版本范围。Letta 的
当前项目入口已把不再维护的 V1 服务端留在 archive 分支,
活跃开发转到 Letta Code。前三节和 4.2 节沿用可复现的 V1 源码,解释 Block、AgentState 与 prompt 重建;
4.3 节跟随当前 Letta Code 的本地后端,说明 Git 文件如何编译并在后续轮次可见。
两条实现都使用固定源码链接;本地后端的结论不扩展为 Cloud/API 后端或私有服务的保证。
一、V1 怎样在创建 Agent 时写入长期记忆
1.1 创建请求先指定要长期保留的 Block
Letta README 的 quickstart 很直接:创建 agent 时可以传入 memory_blocks,
示例里两个 block 分别标成 human 和 persona。这不是回答时临时检索出来的片段,
而是 agent 初始化状态的一部分;同一个创建请求里还会指定模型和工具。
这一点可以从 README 示例
和 CreateAgent.memory_blocks
两边互相印证。
class CreateAgent(BaseModel, validate_assignment=True):
    name: str = Field(default_factory=lambda: create_random_username())

    # memory creation
    memory_blocks: Optional[List[CreateBlock]] = Field(
        None,
        description="The blocks to create in the agent's in-context memory.",
    )
    tools: Optional[List[str]] = Field(None, description="The tools used by the agent.")
创建接口把 memory 和 tools 放在同一个请求里。也就是说,Letta 不是等用户发起 query 后才去找一条旧事实; 它先确定这个 Agent 创建时带着哪些长期上下文,后面再由运行时把这些内容编译进当前 step。
这个入口很重要。外置 memory layer 的典型问题是“这次 query 应该取回哪些历史片段”;Letta 的第一问更早:
这个 agent 被创建时就应该带着哪些长期身份、用户画像和工作约束。前者把记忆当作回答前的候选材料,
后者把记忆当作 agent 可恢复状态的一部分。于是同样一句“用户喜欢简洁回答”,在 Mem0 里更像一条可检索 memory record,
在 Letta 里更像 human block 或 persona 约束,后续每次重建 agent 时都要重新进入模型视野。
创建时:
  1. caller 传入 memory_blocks、model、tools
  2. server 生成 AgentState
  3. memory blocks 成为可持久化 state

回答时:
  1. Memory.compile() 渲染 blocks
  2. system prompt 获得当前记忆
  3. step 成功后消息窗口再 checkpoint
1.2 AgentState 把记忆、工具和消息窗口放在同一张快照里
更关键的是 AgentState 的定义。源码把它描述为“某个时刻的 agent state”,并且说这些信息足以重建一个持久化 agent。
这个 state 里有 message_ids、system prompt、agent type、model、compaction settings、
blocks、tools、sources、tags、secrets、identities 等字段。
换句话说,Letta 的长期记忆并不是单独挂在旁边的一张 facts 表,而是和工具、消息窗口、文件、身份一起进入
AgentState。
class AgentState(OrmMetadataBase, validate_assignment=True):
    """Representation of an agent's state... persisted in the DB backend."""

    message_ids: Optional[List[str]] = Field(...)
    system: str = Field(..., description="The system prompt used by the agent.")
    model: Optional[str] = Field(None, description="The model handle used by the agent.")
    blocks: List[Block] = Field(..., description="The memory blocks used by the agent.")
    tools: List[Tool] = Field(..., description="The tools used by the agent.")
    secrets: List[AgentEnvironmentVariable] = Field(default_factory=list)
    identities: List[Identity] = Field([])
这段源码说明了恢复过程:恢复 Agent 时,memory blocks、工具、消息窗口和身份一起回来。 如果只讲“Letta 有 memory blocks”,读者会漏掉这个更重要的事实:block 的生命周期跟 agent state 对齐, 不跟某一次检索请求对齐。
这解释了 Letta 为什么读起来不像“记忆插件”。如果一个长期 agent 要连续几周工作,系统要恢复的不是一个 facts list,
而是“这个 agent 当时是谁、有哪些工具、当前消息窗口到哪里、哪些上下文块会编译进 prompt、哪些 sources 和 identities 仍然有效”。
AgentState 把这些需要恢复的对象放到一起。记忆不只是被搜到的内容,
也是恢复一个 Agent 时必须重新装配的材料。
| 在 Mem0 里常见的问题 | Letta 里的对应机制 | 这意味着什么 |
|---|---|---|
| 哪些事实值得长期保存? | memory_blocks / blocks |
稳定信息先成为 agent state 的一部分。 |
| 本轮模型能看到什么? | Memory.compile() 与 system prompt |
block 会被渲染成模型可见上下文,而不是只在检索层等待查询。 |
| 对话历史如何延续? | message_ids / conversation in-context messages |
成功 step 之后,当前消息窗口会被 checkpoint。 |
| 记忆如何被长期维护? | block update、block history、MemFS | 记忆更新会影响 prompt,也能写入历史记录或 git-backed 文件体系。 |
二、Block 是上下文里的保留区,不是检索结果
2.1 Block 有预算、标签和权限,所以它不是普通文本片段
Block
在源码注释里被定义为 LLM context window 的 reserved section。它至少有 value、limit、
label、read_only、description、hidden 等字段。
默认的 Human 与 Persona block 也在同一个文件里给出。
这就解释了为什么 Letta 的记忆读起来像“状态槽”:每个 block 有标签、描述、字数限制和权限,而不只是一个相似度命中的文本片段。
class BaseBlock(LettaBase, validate_assignment=True):
    """Base block of the LLM context"""

    value: str = Field(..., description="Value of the block.")
    limit: int = Field(CORE_MEMORY_BLOCK_CHAR_LIMIT)
    label: Optional[str] = Field(None, description="Label of the block...")
    read_only: bool = Field(False, description="Whether the agent has read-only access.")
    description: Optional[str] = Field(None, description="Description of the block.")
    hidden: Optional[bool] = Field(None, description="If set to True, the block will be hidden.")
这几个字段共同规定哪些内容可以稳定占用上下文,哪些内容可以被工具或系统改写。
limit 让 block 不至于无限膨胀;read_only 让某些 block 更像系统约束;
description 给模型或工具解释这个 block 应该放什么;hidden 则给运行时保留“不一定直接显示”的空间。
如果把它误解成“向量检索结果”,就会错过 Letta 的核心:Block 是上下文里的结构化槽位,容量、读写权限和显示方式都有明确字段。
2.2 compile() 把 Block 渲染进这一轮 system prompt
这些 block 最终要进入模型视野。Memory
把它描述为 agent 的 in-context memory,包含带标签的 Block 对象以及编辑这些 block 的工具。
标准渲染路径会输出 <memory_blocks>,并把每个 block 的 label、description、metadata 和 value 写进去;
compile()
再根据 agent type、模型供应商和 git-backed memory 模式选择渲染方式。
def compile(self, tool_usage_rules=None, sources=None, max_files_open=None, llm_config=None, client_skills=None) -> str:
    """Efficiently render memory, tool rules, and sources into a prompt string."""

    if not is_react:
        if self.git_enabled:
            self._render_memory_blocks_git(s)
        elif is_line_numbered:
            self._render_memory_blocks_line_numbered(s)
        else:
            self._render_memory_blocks_standard(s)
持久化 state 可以保存很多对象,但模型这一轮只能看到 compile() 生成的内容。
所以问题不只是“有没有长期存储”,还包括每次 step 前怎样把 Block、sources、tool rules 和消息窗口编译成稳定 prompt。
这也是它和 Mem0 的一个关键差异:Mem0 常把检索结果临时加入模型输入;Letta 先从 Agent state 编译默认上下文,
再在当前 step 里和新消息、工具调用一起运行。

Memory.compile() 进入 system prompt;成功 step 后再 checkpoint 当前消息窗口。
三、为什么更新 block 会牵动 system prompt
3.1 先判断是不是 prompt-affecting change
如果 block 是模型上下文里的保留区,那它一旦变化,系统 prompt 也可能需要重建。Letta 的
BlockManager
明确列出影响 prompt 的 block 字段:description、label、limit、read_only、value。
update_block_async
会判断字段是否真的变化;如果是 prompt-affecting change,就重建所有关联 agent 的 system prompt。
PROMPT_AFFECTING_BLOCK_FIELDS = {"description", "label", "limit", "read_only", "value"}

has_prompt_changes = any(
    key in PROMPT_AFFECTING_BLOCK_FIELDS and getattr(block, key) != value
    for key, value in update_data.items()
)

if has_prompt_changes:
    await self._rebuild_system_prompts_for_connected_agents(block_id, actor)
形状示例:Block 改动如何影响 system prompt
before:
block(label="human", value="用户希望回答短一点")
compiled system prompt contains:
<memory_blocks>
<human>用户希望回答短一点</human>
</memory_blocks>
update:
value = "用户希望先给结论,再展开细节"
after rebuild:
AgentState.blocks 持久化新值
第一条 system message 里的 memory 内容也随之更新
下一轮构造模型请求时,运行时会从 AgentState.blocks 重新编译 memory,
第一条 system message 因此发生变化。也就是说,Block 不是直接交给模型,而是先由运行时渲染进 prompt。
这里的判断比“写数据库”多一层含义。修改 block metadata 可能只是后台记录变化;修改 value、label 或
limit,则可能改变模型下一轮看到的上下文。Letta 把这类字段单独列出来,等于承认 memory update
是 prompt update 的上游。没有这道判断,系统可能出现两种坏结果:数据库里已经是新记忆,但模型仍带着旧 system prompt;
或者每个无关字段变化都重建 prompt,造成不必要的写放大。
3.2 重建 prompt 和 checkpoint 消息窗口是两件事
这一步是 Letta 和“外置检索层”的明显分水岭。Mem0 更像在回答前检索一组可注入事实;
Letta 的 Block 更新则会改变 Agent 默认携带的上下文。旧系统消息里有没有当前 memory string,
_rebuild_memory
会重新编译 memory、sources 和 tool rules,必要时更新第一条 system message。
也就是说,block 不是“查到才生效”,它更像 agent 的人格、用户画像和局部工作台的一部分。
另一方面,Letta 也不是把所有对话都永久塞进 prompt。v3 agent 的
_checkpoint_messages
只在 step 成功后持久化新消息,并更新 message_ids 或 conversation 的 in-context message 集合。
如果系统 prompt 本身超出 context window,源码会单独报 context_window_overflow_in_system_prompt,
说明 Block、工具和 system instructions 也要单独计算容量。
| 动作 | 改变的对象 | 如果混在一起会怎样 |
|---|---|---|
| 更新 block | 长期 state 和后续 system prompt 内容。 | 把它当普通消息,会丢掉“长期槽位”语义。 |
| 重建 memory / system prompt | 模型下一轮看到的基底上下文。 | 如果不重建,持久化 state 和模型实际看到的内容会不一致。 |
| checkpoint messages | 当前 step 成功后的消息窗口和恢复位置。 | 如果把所有历史都当 block,prompt 会快速膨胀。 |
四、Letta Code 把记忆推进到本地长期工作
4.1 MemFS 把上下文资产变成可版本化文件
Letta Code README 把自己称为 stateful agent harness:agent 有 memory、identity 和随时间积累的 experience。 它的功能表里有两项和这一篇最相关: Self-improvement & Learning 说 agent 会重写自己的 context,包括 memory blocks、skills、prompts; MemFS 则说所有 context,包括 memory blocks,都通过 git 跟踪。
这一步继续处理长期上下文。普通 memory Block 解决的是“长期信息怎样进入 Agent state”; MemFS 解决的是“这些上下文资产怎样随着工作积累、被审计、被回滚、被其他机制读取”。如果一个 agent 会长期写代码、总结经验、 调整技能,那么 memory 不再只是用户画像,而会变成一组工作资产:prompt、skills、notes、文件化的上下文和它们的版本历史。
4.2 V1 的渲染规则决定哪些 Block 进入 prompt
V1 服务端里也能看到 git-backed memory 的形状。
_render_memory_blocks_git
会把 system/persona 渲染成 <self>,
其他 system/* block 渲染到 <memory> 的嵌套标签里,
还会把外部 Block 渲染成 file tree。compile_available_skills
也会从 skills/ block 中渲染 agent-scoped skills。
所以 MemFS 不是“顺手把文本放进 git”,而是在把 Agent 的上下文资产变成可版本化、可被 prompt 编译读取的文件系统。
Git-backed memory 并不意味着模型可以任意改写所有上下文,也不意味着文件内容天然适合进 prompt。
关键仍然是渲染规则:哪些 Block 变成 <self>,哪些进入 <memory>,
哪些 skills 被列入可用能力。Letta Code 的价值,是把长期上下文从“一团 prompt 文本”拆成可管理资产;
真正进入模型的一轮视图,仍然由编译路径决定。
4.3 当前本地后端:提交过的文件才进入记忆编译
假设用户要求“默认用英文回答”,Agent 已修改记忆文件,但还没提交。当前 Letta Code 的本地后端不会因为磁盘上出现新文本,
就把它编进下一轮 prompt。collectCommittedMemoryFiles()
先检查 Git HEAD,再用 ls-tree 列出已提交 Markdown,用 git show HEAD:… 读取内容。
对应测试明确验证:已提交的人格文本会出现,工作区里未提交的新文本不会出现。
这让编辑中的草稿与可供编译的记忆分开;未提交的修改仍可能被文件工具读到,因此这个规则只限定记忆编译。
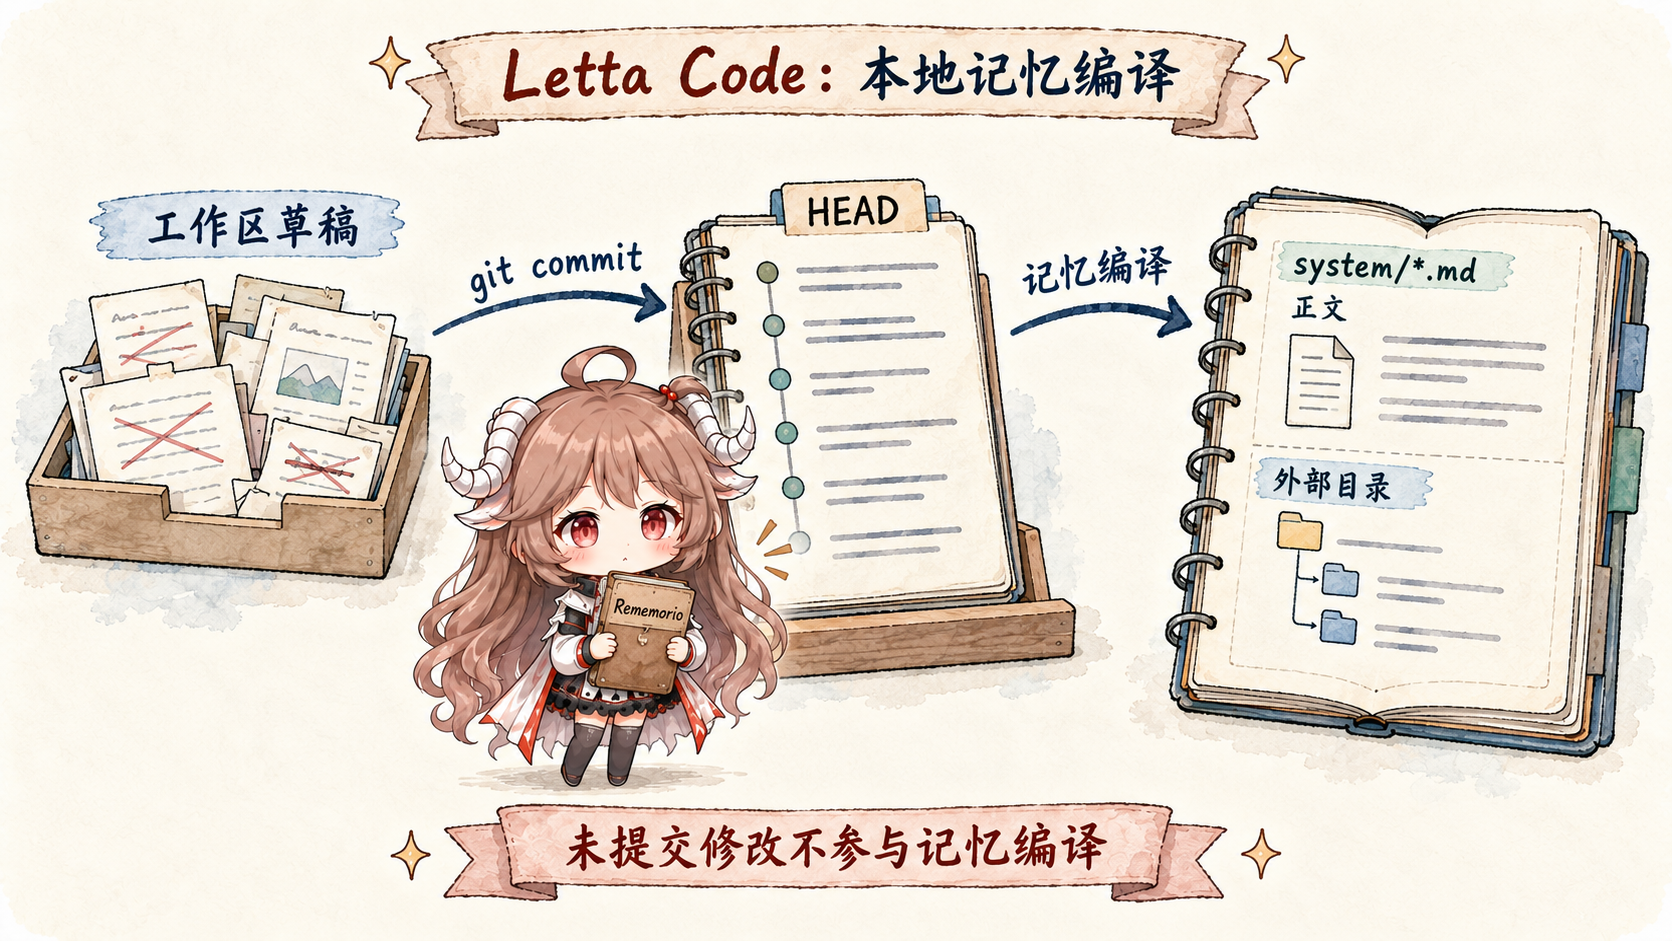
读到文件之后,渲染器沿用熟悉的分工:
system/persona.md 的正文进入 <self>,其他 system/ 文件正文进入 <memory>;
其余非 Skill 文件只形成外部目录,正文需要另行读取。skills/ 被这条投影排除,
本轮请求中的可用 Skill 列表另行附加,不能据此认为所有 Skill 正文已进入模型。
同一条偏好,三个时刻:
工作区已改,HEAD 未变 → 记忆编译仍读取旧内容
Git 已提交,下一轮检查到 revision 变化 → 重新编译
基础 prompt 未变且后端支持对话中系统消息 → 以记忆更新消息送入
其他需要重编译的情况 → 保存并使用重新编译的系统提示词
这个时序由 getOrCompileSystemPrompt()
控制:原始系统提示词的 hash 和记忆 revision 都未变化时复用已保存结果;仅记忆变更且后端支持对话中系统消息时,
保留原始系统消息内容,更新持久记录中的记忆内容与 revision,并返回本轮记忆更新;否则重编译并保存系统提示词。
因而恢复长期记忆要检查的是“已提交的内容、已保存的编译状态与本轮传递方式”,不能只看文件是否存在。
文件读取失败时编译器会跳过相应条目,源码也没有在这组 Git 读取之间建立原子快照;应用不能把一次编译完成当作所有文件都已被完整、原子地读取的证明。
五、和 Mem0 放在一起看
5.1 先比较记忆存在哪里、何时进入模型
Mem0 和 Letta 都在解决长期记忆,但它们的主问题不同。Mem0 适合回答“应用怎样把跨会话事实交给一层 memory service 管”; Letta 适合回答“一个 agent 怎样带着自己的状态、工具、消息窗口和可编辑记忆持续工作”。 前者的中心是 retrieval-time context assembly,后者的中心是 stateful agent reconstruction。
| 问题 | 更像 Mem0 | 更像 Letta |
|---|---|---|
| 记忆主要存在哪里? | 外置 memory layer | agent state |
| 记忆什么时候进入模型? | 回答前检索并注入 | 编译进 system prompt 或当前上下文 |
| 更新会影响什么? | memory store 的记录和后续检索排序 | block、本轮可见上下文、关联 agent 的 system prompt |
| 更适合哪类场景? | 多个应用共享用户事实与偏好 | 长期运行、可自我维护、带工具和身份的 agent |
下一篇进入 Graphiti / Zep,问题会再换一次:如果记忆不是 state slot,而是带时间有效期和来源的 context graph, 系统怎样回答“以前成立、现在不成立、是谁告诉我的”。